ページ上のPythonクロールリンク
C / C ++に加えて、PHP、java、javascript、pythonなど、多くの一般的な言語とも接触しました。その中で、pythonは、最も欠点の少ない操作に最も便利な言語であると言えます。
数日前にクローラーを書きたかったのですが、友達と話し合った後、数日後にまた一緒に書くことにしました。クローラーの重要な部分は、ページ内のリンクを取得することです。ここで簡単に実装します。
まず、オープンソースモジュールのrequestsを使用する必要があります。これはpythonに付属するモジュールではなく、インターネットからダウンロード、解凍、インストールする必要があります。
$ curl -OL https://github.com/kennethreitz/requests/zipball/master
$ python setup.py install
Windowsユーザーが直接[クリックしてダウンロード](https://github.com/kennethreitz/requests/zipball/master)。解凍後、コマンドpython setup.pyinstallをローカルで使用してインストールします。
また、このモジュールのドキュメントをゆっくりと翻訳しています。翻訳後にお渡しします(英語版は最初に添付ファイルに掲載されています)。その説明で述べられているように、人間のために構築され、人間のために設計されています。自分で読んで使うととても便利です。最も単純なrequests.get()は、getリクエストを送信することです。
コードは次のように表示されます。
# coding:utf-8import re
import requests

# Webコンテンツを取得する
r = requests.get('http://www.163.com')
data = r.text

# 通常の接続を使用してすべての接続を検索します
link_list =re.findall(r"(?<=href=\").+?(?=\")|(?<=href=\').+?(?=\')",data)for url in link_list:
 print url
まず、reモジュールとrequestsモジュールをインポートします。reモジュールは、正規の式を使用するモジュールです。
data = requests.get( 'http://www.163.com')、getリクエストをNetEaseホームページに送信し、リクエストオブジェクトrを取得します。r.textは取得したWebページのソースコードであり、文字列データに格納されます。
次に、レギュラーを使用して、データ内のすべてのリンクを検索します。私のレギュラーは比較的ラフです。href= ""またはhref = "の間の情報を直接取得できます。これが必要なリンク情報です。
re.findallが返すのはリストです。forループを使用してリストをトラバースし、出力します。
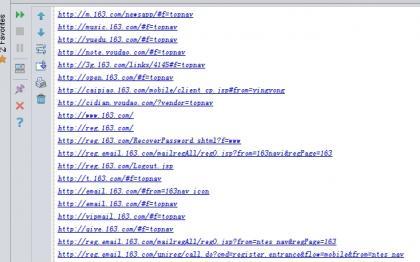
これは私が得るすべての接続の一部です。
上記は、例外を処理せず、ハイパーリンクのタイプを考慮せずに、Webサイト内のすべてのリンクを取得する単純な実装であり、コードは参照用です。リクエストモジュールのドキュメントについては、添付ファイルを参照してください。